
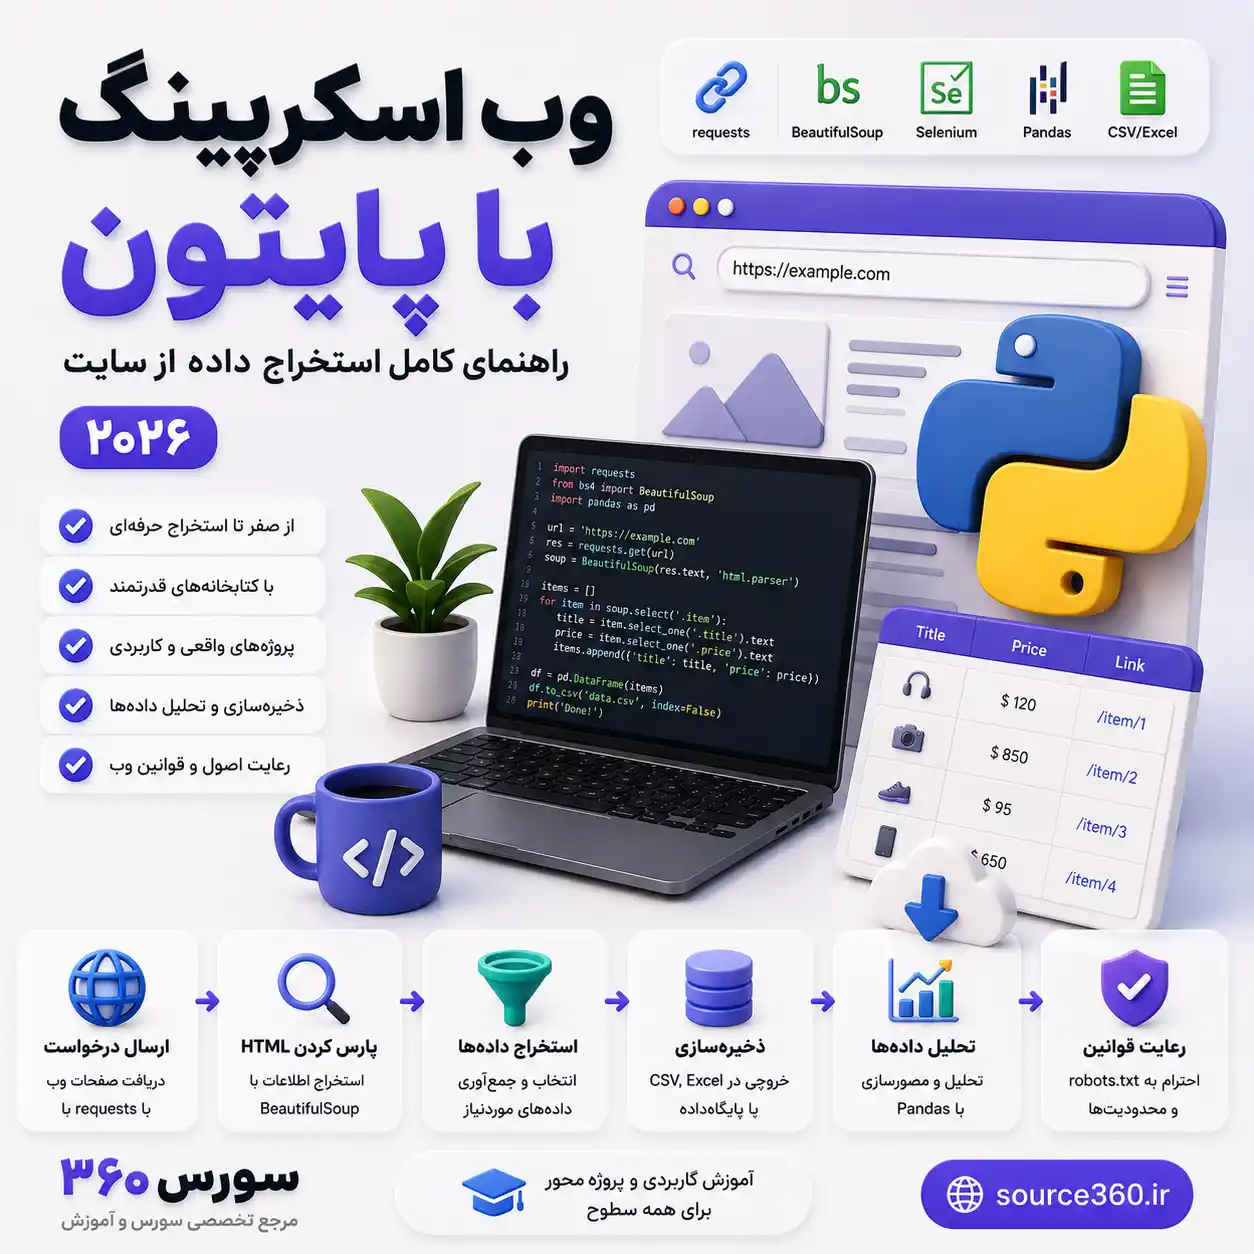
هر بار که خواستید قیمت چند محصول رو از یک سایت جمع کنید، یا لیست خبرها رو تحلیل کنید، احتمالاً به فکرتون رسیده: «کاش میشد این کار خودکار بشه». وب اسکرپینگ دقیقاً همینه — استخراج خودکار داده از صفحات وب با کد، بهجای کپیکردن دستی. توی این راهنما با پایتون از صفر تا یک اسکریپت کامل و کاربردی میریم جلو.
فهرست مطالب
- وب اسکرپینگ چیست و کِی به کارتون میاد؟
- قوانین و اخلاق وب اسکرپینگ
- پیشنیازها
- مرحله ۱: دریافت HTML یک صفحه
- مرحله ۲: استخراج داده با BeautifulSoup
- مرحله ۳: استخراج لیست کامل آیتمها
- مرحله ۴: ذخیره در فایل CSV
- مرحله ۵: مدیریت صفحهبندی
- چالشهای رایج و راهحل
- جدول ابزارهای پرکاربرد
- اشتباهات رایج
- سوالات متداول
وب اسکرپینگ چیست و کِی به کارتون میاد؟
وب اسکرپینگ (Web Scraping) یعنی نوشتن کدی که بهجای شما وارد یک صفحهی وب میشه، محتوای موردنظرتون رو پیدا و استخراج میکنه. کاربردهای رایجش:
- جمعآوری قیمت و مشخصات محصول از یک یا چند فروشگاه (برای مقایسه یا دراپشیپینگ)
- پایش تغییرات قیمت رقبا
- جمعآوری داده برای تحلیل یا آموزش مدلهای یادگیری ماشین
- خودکارسازی وظایف تکراری مثل بررسی موجودی
قوانین و اخلاق وب اسکرپینگ
قبل از هر کدی، این نکات رو جدی بگیرید:
- فایل robots.txt سایت رو چک کنید (مثلاً
example.com/robots.txt) — بخشهایی که سایت اجازهی خزش نمیده رو رعایت کنید. - به سرور فشار نیارید — بین درخواستها فاصله (Delay) بذارید تا سایت مقصد رو کند نکنید.
- دادهی شخصی یا محتوای کپیرایتشده رو بدون اجازه بازنشر نکنید — استخراج دادهی عمومی (مثل قیمت) با کپی و انتشار کامل محتوای یک سایت فرق داره.
- شرایط استفاده (ToS) سایت مقصد رو در نظر بگیرید — بعضی سایتها صراحتاً اسکرپینگ رو منع کردن.
پیشنیازها
pip install requests beautifulsoup4مرحله ۱: دریافت HTML یک صفحه
import requests

url = "https://example.com/products"
headers = {"User-Agent": "Mozilla/5.0"}

response = requests.get(url, headers=headers)
print(response.status_code)
print(response.text[:500])
تنظیم User-Agent مهمه — بدون اون، خیلی از سایتها درخواست پایتون رو بهعنوان ربات مشکوک رد میکنن.
مرحله ۲: استخراج داده با BeautifulSoup
from bs4 import BeautifulSoup

soup = BeautifulSoup(response.text, "html.parser")

title = soup.find("h1").text.strip()
print(title)

# استخراج با CSS Selector
price = soup.select_one(".product-price")
if price:
    print(price.text.strip())
find اولین مورد منطبق رو برمیگردونه؛ select_one با سینتکس آشنای CSS کار میکنه — هرکدوم رو که راحتترید انتخاب کنید.
مرحله ۳: استخراج لیست کامل آیتمها
در عمل، معمولاً یک محصول نیست که میخواید — یک لیست کامله:
products = soup.select(".product-card")

data = []
for product in products:
    name_el = product.select_one(".product-title")
    price_el = product.select_one(".product-price")
    if name_el and price_el:
        data.append({
            "name": name_el.text.strip(),
            "price": price_el.text.strip()
        })

print(data)
نکته: نام کلاسهای .product-card، .product-title و... رو باید با ابزار Inspect مرورگر، از ساختار واقعی سایت مقصد پیدا کنید — هر سایت ساختار متفاوتی داره.
مرحله ۴: ذخیره در فایل CSV
import csv

with open("products.csv", "w", newline="", encoding="utf-8-sig") as f:
    writer = csv.DictWriter(f, fieldnames=["name", "price"])
    writer.writeheader()
    writer.writerows(data)
استفاده از utf-8-sig باعث میشه فایل خروجی توی اکسل هم متن فارسی رو درست نشون بده.
مرحله ۵: مدیریت صفحهبندی
اکثر سایتها محصولات رو در چند صفحه نشون میدن. برای پیمایش خودکار همهی صفحات:
import time
all_data = []
for page in range(1, 11):
url = f"https://example.com/products?page={page}"
response = requests.get(url, headers=headers)
soup = BeautifulSoup(response.text, "html.parser")
products = soup.select(".product-card")
if not products:
break # به آخرین صفحه رسیدیم
for product in products:
name_el = product.select_one(".product-title")
price_el = product.select_one(".product-price")
if name_el and price_el:
all_data.append({"name": name_el.text.strip(), "price": price_el.text.strip()})
time.sleep(1) # فاصله بین درخواستها
print(f"مجموع محصولات استخراجشده: {len(all_data)}")چالشهای رایج و راهحل
- سایتهای محتوای پویا (JavaScript-rendered): اگه محتوا با
requestsخالی برمیگرده، احتمالاً سایت با JavaScript محتوا رو بارگذاری میکنه؛ برای این موارد به ابزارهایی مثل Selenium یا Playwright نیاز دارید که یک مرورگر واقعی رو شبیهسازی میکنن. - مسدودشدن IP: با ارسال درخواست زیاد در زمان کوتاه، سایت مقصد ممکنه IP شما رو موقتاً مسدود کنه — فاصله بین درخواستها رو رعایت کنید.
- تغییر ساختار HTML سایت: اگه سایت مقصد طراحیش رو عوض کنه، کد اسکرپینگ شما از کار میافته و باید Selectorها رو بهروز کنید.
جدول ابزارهای پرکاربرد
| ابزار | مناسب برای |
|---|---|
| Requests + BeautifulSoup | پروژههای ساده و سایتهای استاتیک |
| Scrapy | پروژههای بزرگ با هزاران صفحه |
| Selenium / Playwright | سایتهای مبتنی بر جاوااسکریپت |
اشتباهات رایج
- نادیدهگرفتن robots.txt و نرخ درخواست: میتونه به مسدودشدن دائمی IP منجر بشه.
- عدم بررسی وجود عنصر قبل از استخراج: اگه
select_oneچیزی پیدا نکنه، مقدارNoneبرمیگردونه و مستقیم صداکردن.textروش خطا میده — همیشه چک کنید. - اسکرپکردن سایتهای JS-heavy با ابزار ساده: باعث میشه فکر کنید کدتون خرابه، در حالی که مشکل از انتخاب ابزار غلطه.
سوالات متداول
آیا وب اسکرپینگ قانونیه؟
استخراج دادهی عمومی معمولاً مشکلی نداره، اما رعایت robots.txt، عدم فشار به سرور و توجه به قوانین کپیرایت و ToS سایت مقصد ضروریه.
چرا کدم دادهی خالی برمیگردونه؟
رایجترین دلیل، محتوای بارگذاریشده با جاوااسکریپته که requests نمیتونه ببینتش؛ Selenium یا Playwright رو امتحان کنید.
Scrapy چه فرقی با BeautifulSoup داره؟
BeautifulSoup یک کتابخانهی تجزیهی HTMLه؛ Scrapy یک فریمورک کامل با مدیریت درخواست موازی، صف و ذخیرهسازیه — برای پروژههای بزرگتر مناسبتره.
اگه نمیخوام خودم این کدها رو بنویسم و نگه دارم چیکار کنم؟
افزونهی دیجی اسکراپر ما دقیقاً همین فرآیند رو برای واردکردن محصول به ووکامرس خودکار میکنه، بدون نیاز به نوشتن یا نگهداری کد.
جمعبندی
حالا میدونید چطور با پایتون از هر سایتی داده استخراج کنید — از یک صفحهی ساده تا صفحهبندی کامل. اگه دنبال یک راهحل آماده برای واردکردن محصول به فروشگاه ووکامرسی هستید، این مقاله رو هم ببینید، یا مستقیم از افزونهی دیجی اسکراپر استفاده کنید.
نظرات کاربران
فقط نظرات تاییدشده مدیر نمایش داده میشود.